100万トークンは日本語で何文字? 実際に数えて料金に直す
執筆・監修: 佐々木 航公開 更新 7 分で読めます
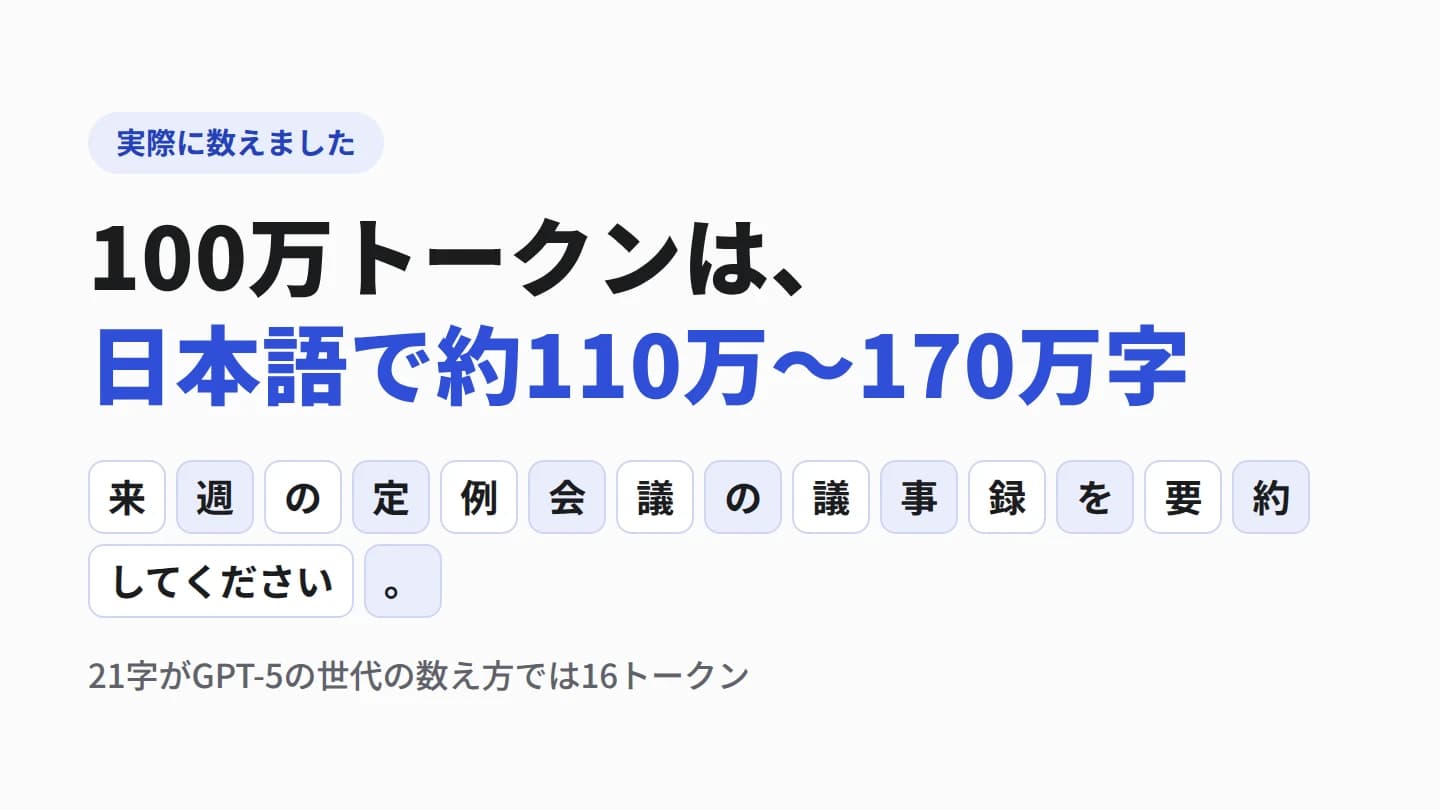
100万トークンは、日本語でおよそ110万〜170万字でした。AIの料金表に必ず出てくる「100万トークンあたり」を、公開されている数え方で実際に数えた結果です。1
「日本語は1文字1〜2トークン」という説明をよく見ます。ところが今のモデルの数え方では、1文字1トークンを下回りました。
トークンは、AIが文章を切った断片
AIの料金は、文字数ではなくトークンの数で決まります。同じ意味の文を実際に切ると、次のようになります。
日本語・GPT-5の世代の数え方21字 → 16トークン
来週の定例会議の議事録を要約してください。
日本語・Qwen3.8の数え方21字 → 14トークン
来週の定例会議の議事録を要約してください。
英語・GPT-5の世代の数え方52字 → 10トークン
Pleasesummarizetheminutesofnextweek'sregularmeeting.
英語は単語に近い単位で切れて、1トークンが約4文字です。日本語は1字か2字ずつ切れる所が多く、同じ意味でも英語よりトークンが増えます。
同じ小説が、数え方で2倍以上変わる
夏目漱石の『吾輩は猫である』を、10の数え方で数えました。
日本語1文字あたりのトークン(『吾輩は猫である』の冒頭)
棒 = 1文字あたりのトークン(長いほど多い)
数値を表で見る
| 順位 | 名前 | 提供元 | 1文字あたりのトークン | 備考 |
|---|---|---|---|---|
| 1 | GPT-3の世代 | OpenAI p50k_base | 1.46 | |
| 2 | GPT-4の世代 | OpenAI cl100k_base | 1.15 | |
| 3 | Mistral Large 4 | Mistral AI | 0.89 | |
| 4 | GPT-5の世代 | OpenAI o200k_base | 0.86 | |
| 5 | Nemotron 3.5 Super VL | NVIDIA | 0.81 | |
| 6 | GLM-5.3 | Z.ai | 0.79 | |
| 7 | DeepSeek V4.1 Flash | DeepSeek | 0.76 | |
| 8 | MiMo-V2.6-Pro | Xiaomi | 0.73 | |
| 9 | Qwen3.8 27B | Alibaba | 0.63 | |
| 10 | MiniMax M3 | MiniMax | 0.58 |
OpenAIの数え方だけを見ると、GPT-3の世代の1.46から、GPT-4で1.15、GPT-5の世代で0.86に減っています。「1文字1〜2トークン」は、古い数え方の値だと考えると辻褄が合います。2
わりと差が大きいのは、会社ごとの違いです。MiniMax M3はGPT-5の世代の約3分の2で済みました。単価が同じなら、日本語では費用に3割ほど差が出る計算です。料金表の単価だけでは、日本語の費用は比べられません。
一方で、ClaudeとGeminiは数え方が公開されていないので、図に入っていません。Anthropicは、Claude Opus 4.7から使う数え方では、前のモデルより3割ほど多くなるとしています。正確に知りたいときは、両社が用意するトークンを数えるAPIを使います。3
文章の種類でも、英語と比べても変わる
| 文章 | 1文字あたりのトークン |
|---|---|
| 日本国憲法 | 0.61〜0.94 |
| 小説 | 0.58〜0.89 |
| 議事録 | 0.54〜0.83 |
| ニュース記事 | 0.47〜0.69 |
| 英語の憲法 | 0.24〜0.26 |
今のモデルの8つの数え方の幅です。英数字が3割ほど混じるニュース記事は、少なめに出ました。英語は1トークン約4文字で、Googleの「1トークンは約4文字」という説明と同じです。
同じ内容なら、日本語のほうがトークンは多くなります。憲法の英語版は約6,100〜6,500トークンで、日本語は6,800〜1万600トークンでした。数え方ごとに比べると、1.1〜1.7倍です。
1,000字の要約は、1回いくらか
1,000字を読ませて200字で要約するとします。GPT-5の世代の議事録の値に合わせ、入力を800トークン、出力を160トークンで計算しました。
| モデル | 1回 / 1,000回 |
|---|---|
| Claude Opus 5.5 | $0.0064 / $6.40 |
| Claude Sonnet 5.5 | $0.0032 / $3.20 |
| GPT-6.1 Sol | $0.0032 / $3.20 |
| Gemini 3.8 Flash | $0.0012 / $1.20 |
| Claude Haiku 5.5 | $0.00016 / $0.16 |
| GPT-6 Luna | $0.00016 / $0.16 |
どのモデルも同じトークン数と仮定した計算で、Claudeは多めに見ておくほうが安全です。数え方の違いも効きますが、上と下で40倍の差があるモデルの選び方のほうが、費用には大きく響きます。4
料金表の外で増える分
ただ、実際の費用は、この計算より増えがちです。理由は2つあります。
1つめは、AIが考える分です。OpenAIもGoogleもAnthropicも、答えの前に考えた分を出力の料金に含めます。出力は入力の5倍の単価なので、よく考えるモデルほど差が開きます。
2つめは、会話の履歴です。AIは前のやりとりを覚えているのではなく、毎回すべてを読み直します。入力も答えも800トークンの会話を10往復すると、答えの合計は8,000トークンでも、入力の合計は8万トークンになります。話題が変わったら新しい会話にするだけで、入力はかなり減ります。5
手元の文章で見積もるなら、日本語1,000字を800〜1,000トークンとして計算しておくと、大きく外れないかもしれません。
YOBITSUGI AIでは、Claude Opus 5.5、Claude Sonnet 5.5、Claude Haiku 5.5、GPT-6.1 Sol、GPT-6 Luna、Gemini 3.8 Flashを選べます。仕事に合うモデルの選び方は、AIモデルの選び方を診断で確かめられます。
出典
- Token counting・Pricing(Claude Platform Docs・2026年11月1日に確認)
- Pricing・Reasoning(OpenAI API Docs・2026年11月1日に確認)・tiktoken(OpenAI・0.14.0)
- Understand and count tokens・Gemini Developer API pricing(Google・2026年11月1日に確認)
- 各モデルのtokenizer.json(Hugging Face・2026年11月1日に取得): Mistral Large 4・Nemotron 3.5 Super VL・GLM-5.3・DeepSeek V4.1 Flash・MiMo-V2.6-Pro・Qwen3.8 27B・MiniMax M3
- 日本国憲法・The Constitution of Japan(国立国会図書館「日本国憲法の誕生」)
- 吾輩は猫である(青空文庫)
注
数えた文章は、日本国憲法の前文と全条文(1万1,268字)、夏目漱石『吾輩は猫である』の冒頭(青空文庫・1万1,893字)、編集部が書いた架空の議事録(448字)、この媒体のニュース記事1本(1,875字)です。字数は空白と改行を除いて数えました。AIへの指示の文は入れていません。今のモデルの幅は、図のGPT-4の世代より下の8つの数え方の最小と最大です。小説の幅(0.58〜0.89)を100万トークンに直すと、約112万〜172万字になります。 ↩
tiktokenの対応表で、p50k_baseはGPT-3の世代、cl100k_baseはGPT-3.5とGPT-4、o200k_baseはGPT-5までのモデルに結び付いています。GPT-6の数え方は、この表では確かめられませんでした。 ↩
3割はClaude Fable 5.1などのページの説明で、中身によって変わるとしています。Anthropicのトークンを数えるAPIは無料です。Googleのcount_tokensも同じ用途に使えます。 ↩
料金は100万トークンあたりの標準の値で、入力/出力はClaude Opus 5.5が$4/$20、Claude Sonnet 5.5とGPT-6.1 Solが$2/$10、Claude Haiku 5.5とGPT-6 Lunaが$0.10/$0.50です。Gemini 3.8 Flashは12月31日までの$0.75/$3.75で計算しました。2027年1月1日からは$1.50/$7.50です。 ↩
繰り返し読ませる部分は、キャッシュで安くなります。Claude Opus 5.5とSonnet 5.5のキャッシュの読み出しは入力の0.05倍です。 ↩