AIモデルの選び方を診断 仕事の目的から4つの質問で(2026年10月版)
公開 6 分で読めます
AIのモデルが多すぎて、どれを使えばいいのか分からない。かといって、いちばん賢いモデルをいつも使うと、費用がかさみます。Artificial Analysisの総合指標では、Claude Opus 5.5とGPT-6.1 Solの差は3点だけでしたが、1つの課題にかかる費用は約8倍違いました。
そこで、2026年10月に公開された評価の結果から、仕事の目的ごとに選ぶ目安を、4つの質問の図にまとめました。図に出てくるモデルは、どれもYOBITSUGI AIで使えます。
4つの質問で選ぶ
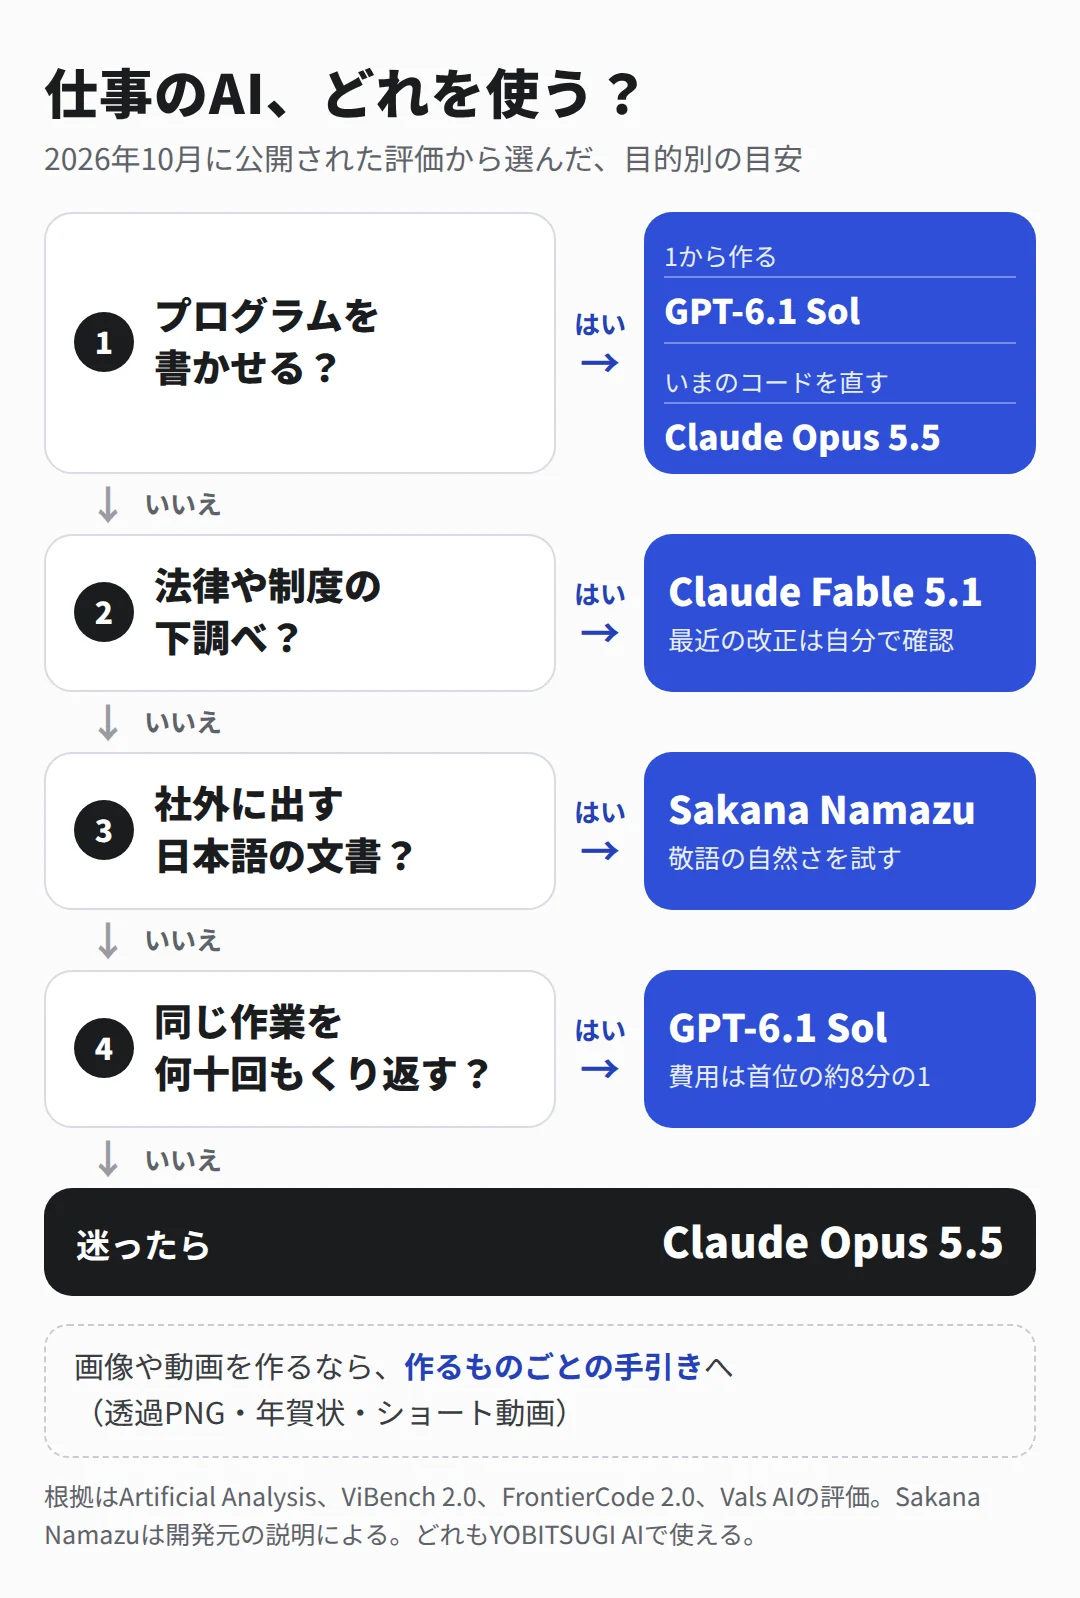
上から順に答えて、最初に「はい」になったところのモデルを使います。どれにも当てはまらなければ、Claude Opus 5.5です。それぞれを選んだ理由を、順に見ていきます。
1. コードは「作る」か「直す」かで分ける
同じコーディングでも、評価によって首位が入れ替わりました。空のプロジェクトから機能を1つずつ足してアプリを作るReplitのViBench 2.0では、最後まですべての試験に通った割合はGPT-6.1 Solが64.7%で首位、Claude Opus 5.5は48.5%でした。費用も、GPT-6.1 Solは1つ作るのに約12ドルと手ごろです(Replit、AIにアプリを1から作らせる評価)。
一方、CognitionのFrontierCode 2.0は、実際の大きなコードに変更を加え、レビューで取り込めるかを見る評価です。こちらでは、Claude Opus 5.5が45.5%で首位でした(FrontierCode 2.0公開 首位のOpus 5.5でも45%)。社内の小さなツールを1から作るならGPT-6.1 Sol、いま動いているシステムを直すならClaude Opus 5.5、と分けるのが目安です。1
2. 法律や制度は、Fable 5.1でも「下調べ」まで
Vals AIが25のモデルに米国の移民法の質問を解かせた評価では、Claude Fable 5.1が首位でした。それでも、専門家が答えに求める項目のうち満たしたのは平均75.4%で、すべてを満たした問題は26.3%です。2025年以降に変わった決まりに触れる項目は、Fable 5.1でも18.5%しか押さえていませんでした(Vals AI、米国の移民法でAIを評価)。
論点を洗い出したり、用語を確かめたりする下調べには役立ちます。ただ、自分の場合にどう当てはまるかの判断と、最近の改正の確認は、役所の案内や専門家に頼るところです。試されたのは米国の法律で、日本の法律での結果は示されていません。2
3. 社外に出す日本語は、Namazuも試す
取引先へのメールや案内文は、内容が正しいだけでなく、敬語や言い回しが自然かどうかも問われます。Sakana AIのSakana Namazuは、オープンモデルのKimi K2.6をもとに、日本語と日本の業務に合わせて調整したモデルです。開発元は、敬語や商習慣を踏まえた日本語で業務の文書を扱えるとしています(Sakana AI、企業向けAPI基盤の先行利用を受け付け開始)。
ただし、ほかのモデルと同じ物差しで比べた第三者の結果は、まだ見当たりません。図ではNamazuを選びましたが、同じ依頼をClaude Opus 5.5にも出し、読み比べて決めるのが確実です。
4. くり返す作業は、GPT-6.1 Solで費用を抑える
Artificial Analysisの総合指標v5では、GPT-6.1 Solは55点で、首位のClaude Opus 5.5の58点に近い位置にいます。1つの課題にかかる費用は、Opus 5.5が10.04ドル、GPT-6.1 Solは1.27ドルでした。問い合わせの分類や、決まった形の下書きを何十件も作るような作業なら、この差がそのまま費用に効いてきます(Artificial Analysis、総合指標v5で首位はOpus 5.5)。
もう1つ効くのが、思考の深さです。Claude Opus 5.5は、いちばん浅いlowの設定だと35点、費用は0.98ドルでした。深さを上げるほど賢くなり、そのぶん高くなります。下書きは浅く、大事な判断は深く、と使い分けると無駄が減ります。3
迷ったら、Claude Opus 5.5
どの質問にも当てはまらない調べものや資料づくりは、Claude Opus 5.5にしておけば大きく外しません。総合指標v5の58点は、いまYOBITSUGI AIで使えるモデルの中でいちばん高い値です。Googleが10月28日に発表したGemini 4 Carbonは59点で上回りましたが、まだ一部の組織にしか提供されていません(Google、Gemini 4 Carbonを発表)。
YOBITSUGI AIでの切り替え方
YOBITSUGI AIでは、入力欄の横の「モデルと思考の深さ」から、中心で動くAI(Claude、OpenAI、Grok)と、そのモデル、思考の深さを選べます。GPT-6.1 Solを使うときは、中心をOpenAIにします。Sakana Namazuは、会話の中で「Sakana AIのNamazuで書いて」と頼むと、中心のAIがNamazuに依頼して、答えを受け取ります。同じ会話の途中で切り替えても、それまでのやり取りは引き継がれます。
点数より、手元の仕事で(編集部の見方)
正直なところ、評価の順位は1か月もたたずに入れ替わります。Artificial Analysisの総合指標でも、Claude Opus 5.5が首位だったのは1日だけでした。しかも、どの評価もほとんどが英語の問題です。図はあくまで最初の目安にして、ふだんの仕事から3つほど例を選び、2つのモデルに同じ依頼をして比べてみると、自分に合う1つがわりと早く見つかるかもしれません。
関連する記事
- 文章・コードのAIの比較(2026年10月)(YOBITSUGI AIメディア)
- AIモデルの性能比較 週次レポート(2026年10月26日)(YOBITSUGI AIメディア)
- 生成AIの使い分け2026年版 同じお題で17回比べて分かった得意分野(ハック!でAI)
出典
- Announcing Artificial Analysis Intelligence Index v5(Artificial Analysis・2026年10月27日)
- ViBench 2.0: A Benchmark for Long-Horizon Software Building(Replit Blog・2026年10月29日)
- FrontierCode 2.0(Cognition・2026年10月27日)
- Can AI Get Immigration Right?(Vals AI・2026年10月28日)
- Sakana Namazu(Sakana AI・2026年10月29日に確認)
注
ViBench 2.0の費用は定価で計算した1つの製品あたりの額で、GPT-6 Astraは約90ドルでした。Artificial Analysisのコーディングエージェントの評価でも、Claude CodeでClaude Opus 5.5を動かした組み合わせが62点で首位です。 ↩
Vals AIの評価で、Claude Fable 5.1の費用は1問あたり約2.11ドルでした。Artificial Analysisの総合指標v5の上位10でも、Claude Fable 5.1は1課題13.04ドルでいちばん高い値です。 ↩
費用は、Artificial Analysisの総合指標の課題1つあたりの額です。Claude Opus 5.5の58点とGPT-6.1 Solの55点は、どちらもmaxの設定での値です。 ↩