日本語の文字起こしAI、料金ランキング 会議1時間でいくら
公開 9 分で読めます
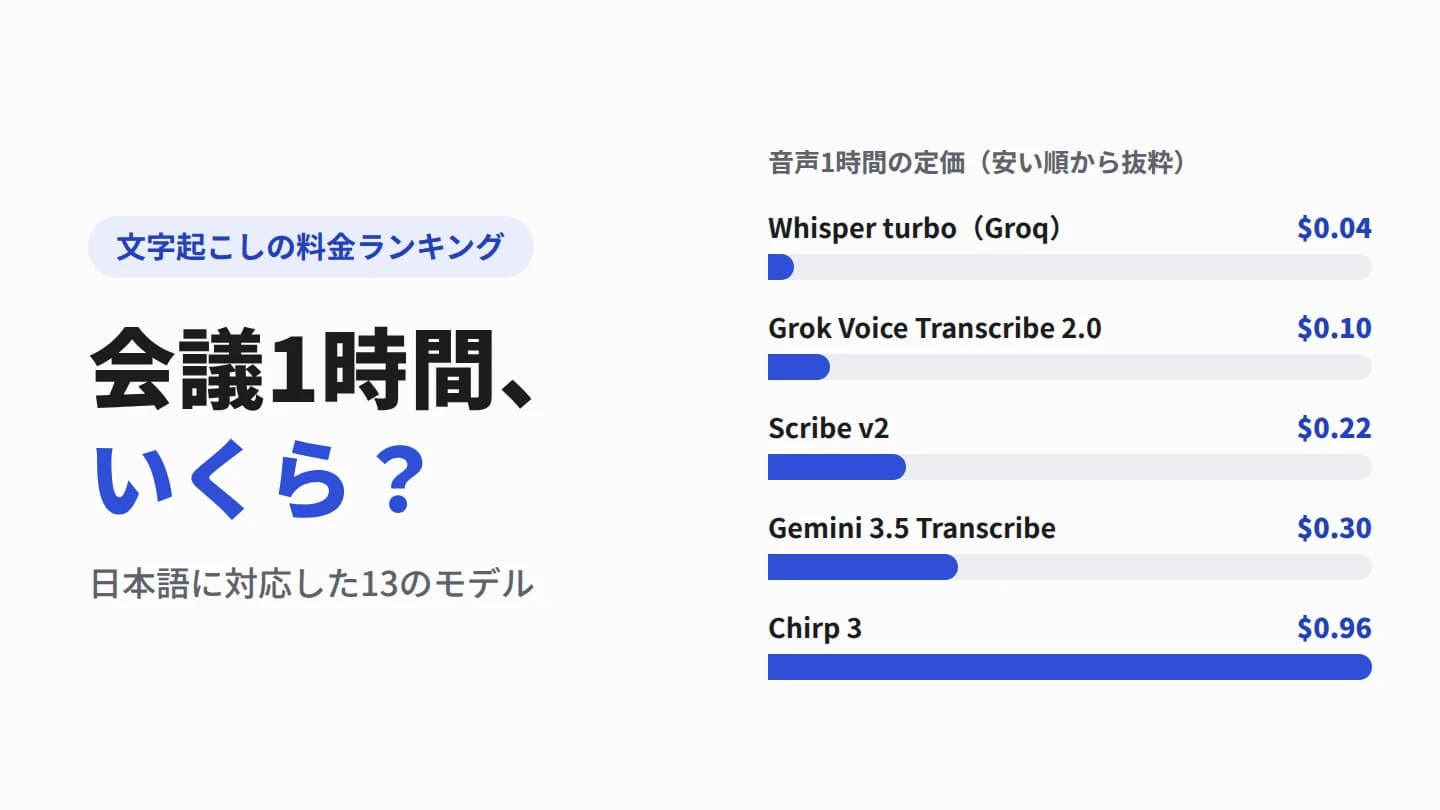
1時間の会議を文字にする料金は、日本語に対応した主な13のモデルで、4セントから96セントまででした。いちばん高いモデルでも1ドルに届きません。
議事録のために文字起こしのAIを選ぶとき、料金の差はわりと小さな問題です。違うのは、長い録音をそのまま渡せるか、話し手を分けられるか、社名や製品名を正しく書けるかのほうです。
下の図は、2026年10月31日に各社の料金表で確かめた定価を、安い順に並べたものです。録音をあとから文字にするときの値で、話しながら文字にする使い方は別の料金です。1
1時間の料金ランキング
文字起こしの料金(音声1時間・安い順)
棒 = 1時間の料金(長いほど高い)使える = YOBITSUGI AIで使えるモデル
数値を表で見る
| 順位 | 名前 | 提供元 | 1時間の料金 | 備考 |
|---|---|---|---|---|
| 1 | Whisper large-v3-turbo | Groq | $0.04 | |
| 2 | Grok Voice Transcribe 2.0 | xAI | $0.10 | |
| 3 | Nemotron 3.5 Transcribe | DeepInfra | $0.12 | |
| 4 | Universal-2 | AssemblyAI | $0.15 | |
| 5 | Voxtral Mini Transcribe 3 | Mistral AI | $0.21 | |
| 6 | Scribe v2 | ElevenLabs | $0.22 | YOBITSUGI AIで使えるモデル |
| 7 | Voxtral Small Transcribe 3 | Mistral AI | $0.24 | |
| 8 | Kotoba STT | fal.ai | $0.25 | |
| 9 | gpt-transcribe | OpenAI | $0.27 | YOBITSUGI AIで使えるモデル |
| 10 | Gemini 3.5 Transcribe | $0.30 | YOBITSUGI AIで使えるモデル | |
| 11 | Amazon Transcribe | Amazon | $0.36 | |
| 12 | Nova-3 | Deepgram | $0.46 | |
| 13 | Chirp 3 | Google Cloud | $0.96 |
1位のWhisperは、OpenAIが公開したモデルをGroqが動かしているものです。ただ、Groqの案内に話し手の区別の機能はなく、OpenAI自身も自社のAPIのWhisperを非推奨にしています。
話し手の区別までまとめて安いのは、2位のGrok Voice Transcribe 2.0です。話し手の区別、単語ごとの時刻、用語の指定を、追加の料金なしで使えます。月に20時間の会議なら、Grokで$2、Scribe v2で$4.40、いちばん高いChirp 3でも$19.20です。
安いほど誤りが多い、とは言えない
料金と正確さは、あまり連動していません。Artificial Analysisが同じ音声で測った単語の誤りの割合を見ると、10セントのGrokは2.3%で、96セントのChirp 3の4.3%より少ない結果でした。
単語の誤りの割合(AA-WER・少ない順)
棒 = 誤りの割合(長いほど誤りが多い)使える = YOBITSUGI AIで使えるモデル
数値を表で見る
| 順位 | 名前 | 提供元 | 誤りの割合 | 備考 |
|---|---|---|---|---|
| 1 | Voxtral Small Transcribe 3 | Mistral AI | 2.1% | |
| 2 | Scribe v2 | ElevenLabs | 2.2% | YOBITSUGI AIで使えるモデル |
| 3 | Voxtral Mini Transcribe 3 | Mistral AI | 2.2% | |
| 4 | Grok Voice Transcribe 2.0 | xAI | 2.3% | |
| 5 | Gemini 3.5 Transcribe | 2.6% | YOBITSUGI AIで使えるモデル | |
| 6 | gpt-transcribe | OpenAI | 3.3% | YOBITSUGI AIで使えるモデル |
| 7 | Nemotron 3.5 Transcribe | DeepInfra | 3.4% | |
| 8 | Universal-2 | AssemblyAI | 3.8% | |
| 9 | Amazon Transcribe | Amazon | 4.1% | |
| 10 | Chirp 3 | Google Cloud | 4.3% | |
| 11 | Whisper large-v3-turbo | Groq | 4.6% | |
| 12 | Nova-3 | Deepgram | 5.2% |
ただし、これは英語の音声で測った値です。日本語でも同じ順番になるとは限りません。2
日本語の値を公表しているモデルは少ない
日本語の正確さは、もっと手がかりが少なくなります。公式のページで日本語の値を確かめられたのは、次の4つでした。
| モデル | 日本語の値 |
|---|---|
| Nemotron 3.5 Transcribe | 文字の誤り4.42% |
| Qwen3-ASR-1.7B | 誤り5.20% |
| Scribe v2 | 5%以下の区分 |
| Universal-2 | 10%以下の区分 |
どれも開発元の自己申告で、測り方もそろっていません。4.42%と5.20%は、読み上げの音声を集めたFLEURSの値です。Qwen3-ASRは重みを公開したモデルで、1時間の定価を持たないため、ランキングには入れていません。3
会議の録音は、読み上げよりずっと難しくなります。Hugging Faceの測定では、人が話し重なる英語の会議の録音で、試したエンジンはどれも単語の誤りが23%を超えました。
議事録で効くのは、1本の上限と話し手の区別
| モデル | 1本の上限 / 話し手の区別 |
|---|---|
| Scribe v2 | 10時間 / 32人まで |
| Voxtral Small Transcribe 3 | 3時間 / あり |
| Grok Voice Transcribe 2.0 | 500MB / あり |
| Gemini 3.5 Transcribe | 1時間 / 8人まで |
| Nemotron 3.5 Transcribe | 1時間 / あり |
| gpt-transcribe | 25MB / 専用のモデルは非推奨 |
| Kotoba STT | 2分 / 案内なし |
1時間の会議で引っかかる所があります。gpt-transcribeの25MBは、1時間の音声なら約55kbpsの計算で、音質の高い録音は分けて送ることになります。Gemini 3.5 Transcribeは、話し手を分けると1本30分までです。Kotoba STTは日本語に合わせて調整したモデルですが、1回2分までなので、会議の録音は細かく切る必要があります。そのかわり、Scribe v2なら10時間まで1本で渡せます。
社名や製品名を先に渡せるモデルもあります。gpt-transcribeはkeywordsで、Scribe v2は1時間5セントの追加で、Grokは追加の料金なしで指定できます。Gemini 3.5 Transcribeの語の指定は、話し手の区別と同時には使えません。
話し手を分けるなら、GrokかScribe v2から
編集部なら、話し手を分けた議事録はGrok Voice Transcribe 2.0かScribe v2から試します。Grokは安く、Scribe v2は長い録音をそのまま渡せて、日本語の区分も公表しているからです。
社外に出せない録音なら、重みを公開したNemotron 3.5 TranscribeやQwen3-ASRを、自社の機械で動かす形になります。
料金の差は、1時間で数十セントです。同じ会議の5分を2つか3つのモデルに通して、社名と数字の誤りを数えてから決めるのがよいかもしれません。
YOBITSUGI AIでは、文字起こしにElevenLabsのScribe v2、OpenAIのgpt-transcribe、GoogleのGemini 3.5 Transcribeを使えます。図の「使える」の印が、そのモデルです。ほかのモデルは、現時点の対応モデルには含まれていません。読み上げや音楽のモデルは音声・音楽のAIの比較で見比べられます。
出典
- Introducing Grok Voice Transcribe 2.0(xAI・2026年9月18日)・Speech to Text(xAI Docs・2026年10月31日に確認)
- Speech to text(Groq Docs・2026年10月31日に確認)
- NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(DeepInfra・2026年10月31日に確認)・NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(Hugging Face)
- Pricing・Supported languages(AssemblyAI・2026年10月31日に確認)
- Voxtral 3: Voice Agent SDK & Speech Models in 50+ Languages(Mistral AI・2026年10月20日)・Audio transcription(Mistral AI Docs・2026年10月31日に確認)
- API pricing・Speech to Text(ElevenLabs・2026年10月31日に確認)
- Kotoba (Speech to Text) API on fal(fal.ai・2026年10月31日に確認)
- Pricing・Speech to text(OpenAI API Docs・2026年10月31日に確認)
- Gemini Developer API pricing・Gemini 3.5 Transcribe(Google・2026年10月31日に確認)
- Amazon Transcribe pricing(AWS・2026年10月31日に確認)
- Pricing・Models & Languages Overview(Deepgram・2026年10月31日に確認)
- Speech-to-Text pricing(Google Cloud・2026年10月31日に確認)
- Speech to Text・Methodology(Artificial Analysis・2026年10月31日に確認)
- MAI-Transcribe in Azure Speech(preview)(Microsoft Learn・2026年10月31日に確認)
- Qwen3-ASR Technical Report(arXiv・2026年1月29日)
- Introducing AnySpeechRecognizer and AnyDecisionModel(Hugging Face Blog・2026年10月29日)
注
話しながら文字にする使い方の1時間の料金は、Grok Voice Transcribe 2.0が$0.20、Scribe v2 Realtimeが$0.39、Voxtral Mini Transcribe Realtime 3が$0.48、gpt-live-transcribeが$1.02です。図の分単位の料金は60倍しました。Gemini 3.5 Transcribeは公式の目安の1分約$0.005、Nova-3は1つの言語を指定するときの定価、Amazon Transcribeは料金の説明の例にある1分$0.006、Chirp 3はGoogle Cloudの標準の料金で計算しています。話し手の区別は、Universal-2では1時間$0.02の追加です。gpt-transcribeは対応する言語の一覧が公式のページにありません。 ↩
評価に使うのは、音声エージェントとの会話、議会の演説、決算説明会の3つです。MicrosoftのMAI-Transcribe-2(プレビュー)は、この評価で2.0%、1,000分$1.67でした。1時間の定価を公式のページで確かめられなかったので、図には入れていません。 ↩
Nemotron 3.5 TranscribeはNVIDIAの、Qwen3-ASRはAlibabaの技術報告の値です。Qwen3-ASRの報告には、日本語を単語と文字のどちらで数えたかが書かれていません。Scribe v2はElevenLabsが「5%以下」、Universal-2はAssemblyAIが「10%以下」の区分に日本語を入れているという意味で、どちらも単語の誤りの割合の区分です。 ↩