
ローカルLLMのVRAM早見表 どのモデルが24GBで動く?
執筆・監修: 佐々木 航公開 更新 9 分で読めます
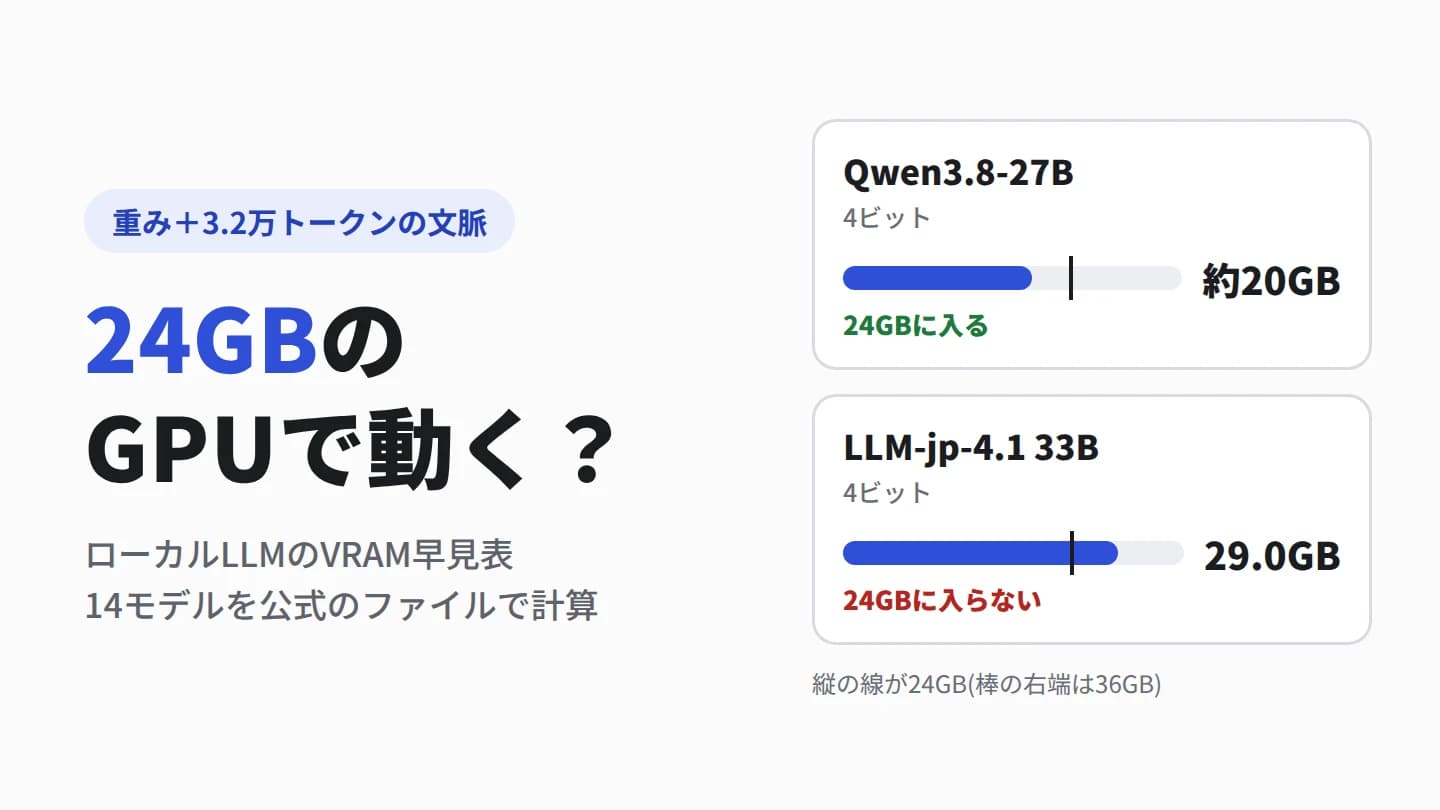
VRAMが24GBのGPUで、30B級のモデルは動くのか。4ビットにしたQwen3.8-27Bなら、3.2万トークンの文脈を持たせても約20GBで収まります。同じ30B級でも、LLM-jp-4.1 33Bは29.0GBになり、24GBには入りません。
差を生むのは、重みの大きさではありません。読んだ文章を覚えておくためのメモリ、KVキャッシュの大きさです。
数字は、Hugging Faceにある14モデルの公式のファイルと、設定ファイル(config.json)から出した値です。どれも2026年11月7日時点のものです。1
要るメモリは「重み」と「文脈」の足し算
重みの大きさは、ほぼパラメーターの数で決まります。BF16は1パラメーターあたり2バイト、FP8は1バイトです。llama.cppでよく使う4ビットの形式(Q4_K_M)は、公式に配られている4つのファイルで比べると、BF16の0.31〜0.34倍でした。MicrosoftがFoundry Localで4ビットにしたQwen3.8-27Bも約18GBで、BF16の55.6GBのおよそ3分の1です。
文脈のメモリは、読ませたトークンの数に比例して増えます。NVIDIAの技術ブログにある式では、1トークンあたりのKVキャッシュは次のとおりです。
2(KとVの2つ)
× 注意の層の数
× KVのヘッドの数
× ヘッドの次元
× 1つの値のバイト数
3.2万トークンは、日本語ならおよそ3.2万〜4万字です。日本語の文字数とトークンの関係も参考になります。
この式は、公式の値とも合いました。LFM3-1.7Bで計算すると、13万1,072トークン(128K)で1.61GB。Liquid AIの説明も「128Kの文脈で1.6GB」です。
手元のGPUに載る8モデル
| モデル | 重み | 文脈 | 合計 |
|---|---|---|---|
| LFM3-1.7BLiquid AI・4ビット | 1.1 | 0.4 | 1.5 |
| LLM-jp-4.1 8B国立情報学研究所・4ビット | 5.5 | 4.3 | 9.8 |
| gpt-oss-20bOpenAI・MXFP4 | 13.8 | 0.8 | 14.6 |
| Qwen3.8-27BAlibaba・4ビット(Microsoftの版) | 約18 | 2.1 | 約20 |
| LLM-jp-4.1 32B-A3B国立情報学研究所・4ビット | 21.5 | 2.1 | 23.7 |
| LLM-jp-4.1 33B国立情報学研究所・4ビット | 20.4 | 8.6 | 29.0 |
| Qwen3.8-27BAlibaba・FP8(公式) | 30.9 | 2.1 | 33.0 |
| gpt-oss-120bOpenAI・MXFP4 | 65.2 | 1.2 | 66.5 |
| Nanbeige4.3-33BBOSS直聘・BF16 | 66.2 | 7.0 | 73.2 |
単位はGB。文脈は3.2万トークンの分です。4ビットは、LFM3とLLM-jp-4.1が公式のQ4_K_Mのファイルです。
表の合計は、同時に1件だけ処理するときの最低限の量です。実行するツールが使う分は入っていません。なお、Microsoftは、KVキャッシュの量子化やCPUへの退避などを組み合わせて、4ビットのQwen3.8-27Bを24GBのGPUで6.4万トークンまで扱えるとしています。32GB以上のGPUなら、最大の26万2,000トークンまでです。
OpenAIは、gpt-oss-20bは16GBのメモリで、gpt-oss-120bは80GBのGPU1枚で動くとしています。計算でも14.6GBと66.5GBで、どちらも収まります。
意外なのはQwen3.8-27Bです。Alibabaが配る版で最も小さいのはFP8の30.9GBですが、3.2万トークンを足すと33.0GBになり、RTX 5090の32GBにも入りません。そのため、24〜32GBのGPUで使うなら、4ビットの版を選ぶことになります。
文脈のメモリは、作りで最大300倍違う
文脈の1トークンあたりのKVキャッシュ
棒 = KVキャッシュ(長いほど多い)
数値を表で見る
| 順位 | 名前 | 提供元 | KVキャッシュ | 備考 |
|---|---|---|---|---|
| 1 | LLM-jp-4.1 33B | 国立情報学研究所 | 262.1KB | 64層すべてで前の文章を見る |
| 2 | Nanbeige4.3-33B | BOSS直聘 | 213.0KB | 52層すべてで前の文章を見る |
| 3 | LLM-jp-4.1 8B | 国立情報学研究所 | 131.1KB | 32層すべてで前の文章を見る |
| 4 | Qwen3.8-27B | Alibaba | 65.5KB | 64層のうち16層だけ |
| 5 | LLM-jp-4.1 32B-A3B | 国立情報学研究所 | 65.5KB | KVのヘッドが4つ |
| 6 | gpt-oss-120b | OpenAI | 36.9KB | 36層のうち18層だけ |
| 7 | gpt-oss-20b | OpenAI | 24.6KB | 24層のうち12層だけ |
| 8 | LFM3-1.7B | Liquid AI | 12.3KB | 24層のうち6層だけ |
| 9 | DeepSeek V4.1 Flash | DeepSeek | 0.9KB | 公表値の890バイト。4ビットで保持 |
いちばん多いLLM-jp-4.1 33Bは、1トークンあたり262.1KBで、Qwen3.8-27Bの4倍です。正直なところ、性能の表だけを見ていても、この差には気づけません。
LLM-jp-4.1とNanbeige4.3-33Bは、すべての層で前の文章を残らず見る、ふつうの作りです。Qwen3.8-27Bでそうなっているのは64層のうち16層だけで、残りの48層は、決まった大きさの状態だけを持つ線形の注意(Gated DeltaNet)です。gpt-ossは層の半分が直近の128トークンだけを見て、LFM3-1.7Bは24層のうち6層だけが前の文章をすべて見ます。
DeepSeek V4.1 Flashは、DeepSeekの公表で1トークンあたり890バイトです。KVキャッシュを縮めたうえで4ビットで持つ作りで、100万トークンを読ませても約0.9GBにとどまります。
つまり、長い資料を読ませるほど、この差が効きます。ただ、LLM-jp-4.1 33Bも、文脈を8,000トークンほどに絞れば、計算では22.6GBで24GBに収まります。また、vLLMなどには、KVキャッシュを8ビット(FP8)で持つ設定もあり、文脈の分は半分になります。
機器のメモリごとの目安
3.2万トークンの文脈まで含めて、収まる組み合わせです。
| メモリ | 収まる公式の重み |
|---|---|
| 16GB | LFM3-1.7B・LLM-jp-4.1 8B(4ビット)・gpt-oss-20b |
| 24GB | 上に加えて、Qwen3.8-27B(4ビット) |
| 32GB(RTX 5090など) | 上に加えて、LLM-jp-4.1 33B(4ビット)・LLM-jp-4.1 32B-A3B(4ビット) |
| 80GB(H100など) | 上に加えて、gpt-oss-120b・Nanbeige4.3-33B・BF16のQwen3.8-27BとLLM-jp-4.1 33B・32B-A3B |
LLM-jp-4.1 32B-A3Bの4ビットは23.7GBで、24GBのGPUでは余裕がほとんど残りません。DGX SparkやMacの128GBの統合メモリでも、次に大きいQwen3.8-Flash-Next(FP8で185.5GB)には届きません。しかも統合メモリは、OSやほかのアプリと分け合います。
機器ごとの生成の速さは、手元の機器でエージェントを動かした比較で確かめられます。
GPUサーバーが要る6モデル
| モデル | 重み | 1枚あたり |
|---|---|---|
| Qwen3.8-Flash-NextAlibaba・FP8 | 185.5 | 23.2 |
| DeepSeek V4.1 Flash 1017DeepSeek | 510.3 | 63.8 |
| Mistral Large 4Mistral AI・NVFP4 | 610.0 | 76.3 |
| GLM-5.3Z.ai・FP8 | 755.6 | 94.5 |
| Hy4 previewTencent・FP8 | 813.8 | 101.7 |
| Mistral Large 4Mistral AI・FP8 | 1,060.6 | 132.6 |
| Kimi K3.1 ProMoonshot AI・MXFP4 | 1,561.3 | 195.2 |
単位はGB。1枚あたりは、8枚のGPUに分けたときの値です。どれも公式の重みのファイルの合計で、文脈の分は入っていません。
H100は80GB、H200は141GBです。DeepSeek V4.1 Flashは1枚あたり63.8GBで、H100の8枚に収まります。GLM-5.3とHy4 previewはH100には入らず、H200の8枚が目安です。Kimi K3.1 Proは1枚あたり195.2GBで、H200の8枚でも重みが入りきりません。Mistral Large 4の4ビットの版(NVFP4)は、Blackwell世代のGPU向けです。
こうしたサーバーを借りるなら、GPUクラウドの選び方で、時間単位の借り方や料金の例を比べられます。
手元に置くモデルを選ぶときは、性能の点と同じくらい、1トークンあたりのKVキャッシュを見ておくとよいかもしれません。
このうちMistral Large 4は、YOBITSUGI AIでも使えます。GPUを用意する前に、答えの質を試せます。DeepSeek V4.1 Flashを含むほかの13モデルは、YOBITSUGI AIで公開している対応AIの一覧には含まれていません。
2026年11月7日 訂正:Microsoftの例を「計算で約22GBになる組み合わせで、余裕は1割弱」と書いていましたが、MicrosoftはKVキャッシュの量子化やCPUへの退避を組み合わせています。BF16で出した値は当てはまらないため、Microsoftの説明どおりに直しました。
2026年11月9日 訂正:DeepSeek V4.1 FlashをYOBITSUGI AIで使えると書いていましたが、YOBITSUGI AIで公開している対応AIの一覧には含まれていません。本文と図の印を直しました。
出典
- Mastering LLM Techniques: Inference Optimization(NVIDIA Technical Blog・2023年11月17日)
- Quantized KV Cache(vLLM Documentation・2026年11月7日確認)
- Introducing LFM3: Every Modality for Specialized Intelligence(Liquid AI・2026年10月27日)
- Bring Agentic Coding On-Device with Foundry Local(Microsoft Foundry Blog・2026年11月5日)
- DeepSeek-V4.1-Flash(Hugging Face・2026年11月7日確認)
- Hugging Faceの各モデルのページとファイル(2026年11月7日確認):LFM3-1.7B・LFM3-1.7B-GGUF・llm-jp-4.1-8b-thinking-gguf・llm-jp-4.1-32b-a3b-thinking-gguf・llm-jp-4.1-33b-thinking-gguf・gpt-oss-20b・gpt-oss-120b・Qwen3.8-27B・Qwen3.8-27B-FP8・Nanbeige4.3-33B・Qwen3.8-Flash-Next-FP8・DeepSeek-V4.1-Flash-1017・Mistral-Large-4-1T-A52B・Mistral-Large-4-1T-A52B-NVFP4・GLM-5.3・Hy4-preview-FP8・Kimi-K3.1-Pro
- GeForce RTX 5090・DGX Spark・H100・H200(NVIDIA・2026年11月7日確認)
注
同時に1件を処理するときの値です。KVキャッシュはBF16(1つの値に2バイト)、1GBは10億バイトです。重みは公式のファイルの合計で、画像を読む部分なども含みます。LLM-jp-4.1は、thinkingの版の値です。 ↩
